Google durchsucht das Internet heute nicht mehr auf der Suche nach passenden Zeichenketten, sondern auf der Suche nach eindeutig identifizierbaren Objekten und Konzepten – den sogenannten Entitäten. Diese fundamentale Verschiebung hat die Suchmaschinenoptimierung in den letzten zehn Jahren grundlegend verändert und stellt viele klassische Optimierungsansätze auf den Kopf. Wer weiterhin ausschließlich auf eine hohe Keyword-Dichte setzt, verliert unweigerlich an Sichtbarkeit gegenüber Wettbewerbern, die ihre Inhalte thematisch tiefgreifend und semantisch klar strukturieren. Google verknüpft Begriffe längst mit realen Objekten, Personen, Orten und abstrakten Konzepten und bewertet dabei sehr genau, wie präzise ein Text diese Zusammenhänge tatsächlich abbildet.
In diesem umfassenden Beitrag erfährst du, was Entitäten konkret sind, wie der Google Knowledge Graph als semantische Datenbank im Hintergrund funktioniert und welche Algorithmus-Updates den Weg zur heutigen entitätsbasierten Suche bereitet haben. Darüber hinaus zeigen wir dir praxisnah, wie du deinen Content so aufbaust, dass Google und moderne KI-Suchsysteme wie Google AI Overviews oder ChatGPT ihn fachlich richtig einordnen können. Durch intelligent angewandtes Entitäten SEO machst du deine Website langfristig unabhängig von reinen Suchbegriffen und stärkst gleichzeitig deine thematische Relevanz sowie deine Chancen auf Sichtbarkeit im Knowledge Panel und in KI-gestützten Suchergebnissen spürbar.
Rik Steinicke ist Gründer von wir-branden.de und seit über 15 Jahren im Online-Marketing, Branding und SEO tätig. Er positioniert Unternehmen strategisch so, dass sie nachhaltig wachsen und Vertrauen aufbauen. Sein Ansatz ist ganzheitlich: Marketing beginnt für ihn bei der Klarheit der Marke und wird in messbares Wachstum übersetzt – mit Fokus auf Inhalte für Menschen, nicht für Algorithmen.
Inhaltsverzeichnis:
- Was ist eine Entität? Definition und Abgrenzung zum Keyword
- Der Google Knowledge Graph: Die Datenbank hinter der semantischen Suche
- Von Hummingbird bis MUM – wie Google den Weg zur semantischen Suche ging
- Wie Google Entitäten in Texten erkennt (NLP, NER, Salienz)
- E-E-A-T und Entitäten: Warum Vertrauen über Sichtbarkeit entscheidet
- Entitäten mit strukturierten Daten auszeichnen
- Entitäten für die eigene SEO-Strategie recherchieren
- Brand Mentions, Google Business Profil und lokale Entitäten
- Häufig gestellte Fragen (FAQ)
- Fazit

Was ist eine Entität? Definition und Abgrenzung zum Keyword
Eine Entität ist ein eindeutig identifizierbares Objekt oder Konzept, das von Suchmaschinen in einen festen semantischen Kontext eingeordnet wird. Dabei kann es sich um eine reale Person, ein konkretes Unternehmen, einen geografischen Ort, ein historisches Ereignis oder auch um einen abstrakten Begriff handeln. Entscheidend ist dabei nicht der verwendete Name, sondern die Eindeutigkeit: Eine Entität lässt sich unabhängig von der sprachlichen Formulierung klar von anderen Objekten unterscheiden. Ein anschauliches Beispiel liefert der Begriff „Amazon“, der je nach Kontext entweder den gewaltigen Fluss in Südamerika oder das global agierende E-Commerce-Unternehmen bezeichnet. Eine reine Keyword-Suche könnte diese Mehrdeutigkeit kaum auflösen – Google hingegen erkennt anhand von Attributen und Zusammenhängen zuverlässig, welche Entität in einer konkreten Suchanfrage tatsächlich gemeint ist. Ähnlich verhält es sich mit dem Wort „Puma“, das sowohl das Raubtier als auch die bekannte Sportmarke bezeichnen kann. Beide Entitäten unterscheiden sich klar durch ihre jeweiligen Eigenschaften, etwa die Körpergröße bei der Raubkatze oder das Gründungsjahr beim Unternehmen.
Der Begriff Entität stammt ursprünglich aus der Philosophie, wurde jedoch vor allem durch die Informatik geprägt. Grundlage ist das sogenannte Entity-Relationship-Modell (ER-Modell), das der Informatiker Peter Chen bereits 1976 veröffentlichte, um Objekte und ihre Beziehungen strukturiert in Datenbanken abzubilden. In einem Google-Patent wird eine Entität definiert als „a thing or concept that is singular, unique, well-defined, and distinguishable“ – ein Ding oder Konzept, das einzigartig, klar definiert und unterscheidbar ist. Ein häufiges Missverständnis muss an dieser Stelle korrigiert werden: Nicht jede Suchanfrage ist automatisch eine Entität. Entitäten sind eindeutige Objekte, keine beliebigen Suchbegriffe – ein Unterschied, der für die praktische SEO-Arbeit von zentraler Bedeutung ist.
Kernmerkmale einer Entität:
- Eindeutig identifizierbar und klar von anderen Objekten abgrenzbar, unabhängig vom verwendeten Begriff
- Für Suchmaschinen maschinell identifizierbar, meist über eine eindeutige ID in einer großen Datenbank
- Sprachunabhängig speicherbar, da für den Algorithmus stets das Konzept hinter dem Wort zählt
- Mit spezifischen Attributen versehen, die sie klar von anderen Entitäten abgrenzen
- Über Relationen mit weiteren Entitäten und Ereignissen verknüpft
Benannte Entitäten vs. abstrakte Konzepte
Bei Entitäten wird grundsätzlich zwischen benannten Entitäten (Named Entities) und abstrakten Konzepten unterschieden. Benannte Entitäten sind konkrete, real existierende Objekte wie Personen, Orte oder Organisationen. Konzepte hingegen beschreiben abstrakte Begriffe und Ideen, die sich schwerer greifen lassen, wie etwa „Vertrauen“, „Menschenrechte“ oder das Phänomen einer „Geisterstadt“. Ein konkretes Beispiel verdeutlicht den Unterschied sehr gut: „Rhyolite“ ist eine benannte Entität – eine reale Geisterstadt im US-Bundesstaat Nevada mit festem Gründungsdatum und geografischen Koordinaten. „Geisterstadt“ selbst ist dagegen ein abstraktes Konzept, das keine bestimmte Stadt bezeichnet, sondern die allgemeine Idee einer verlassenen Siedlung beschreibt.
Für die praktische Content-Erstellung ist diese Unterscheidung sehr relevant: Benannte Entitäten lassen sich vergleichsweise einfach über strukturierte Daten auszeichnen und maschinenlesbar machen, während abstrakte Konzepte deutlich mehr erklärenden Kontext im Fließtext benötigen, um von Google korrekt verstanden zu werden. Wer diesen Unterschied bei der Content-Planung ignoriert, läuft Gefahr, entweder technische Auszeichnungsmöglichkeiten ungenutzt zu lassen oder abstrakte Themen zu oberflächlich zu behandeln.
Merksatz: Benannte Entitäten sind konkret und zählbar, Konzepte sind abstrakt und erklärungsbedürftig – beide erfordern unterschiedliche Optimierungsansätze und sollten in der Content-Strategie getrennt betrachtet werden.
Der Google Knowledge Graph: Die Datenbank hinter der semantischen Suche
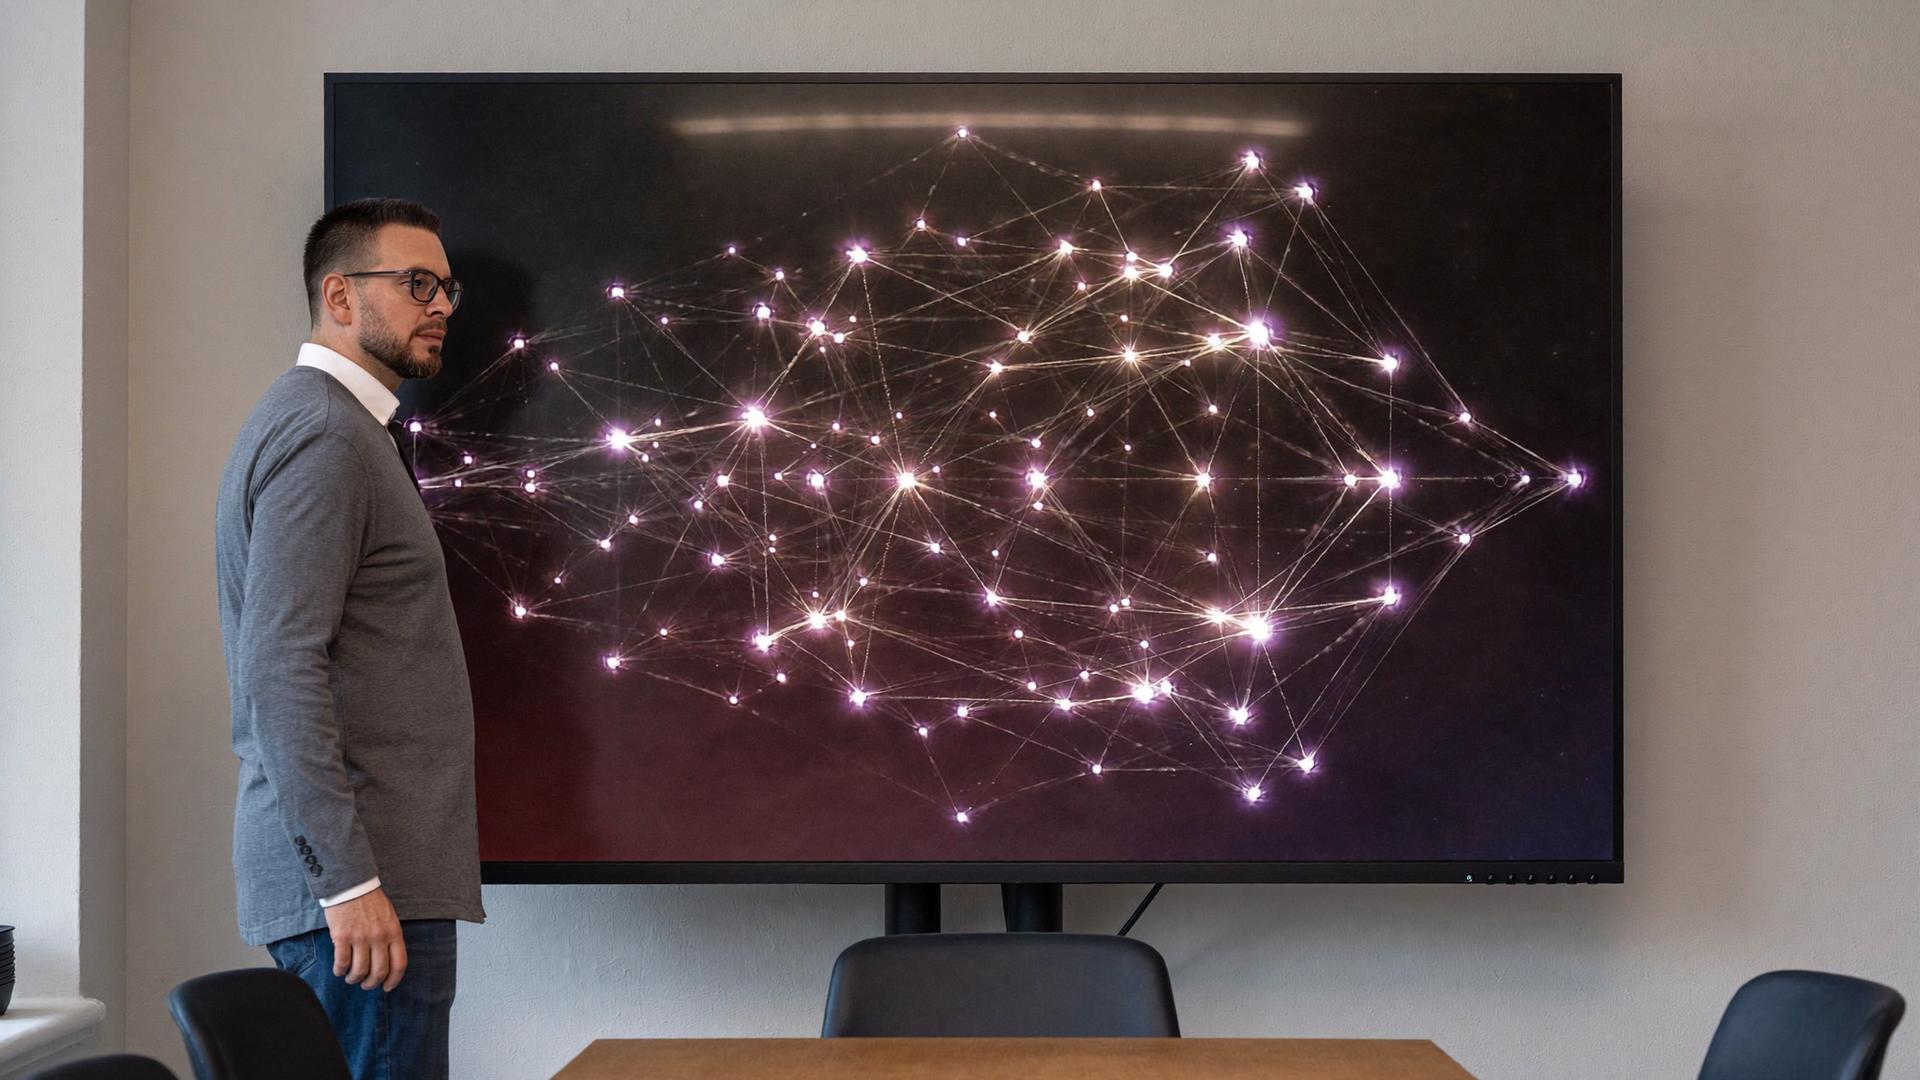
Seit 2012 nutzt Google den Knowledge Graph unter dem bekannten Motto „Things, not strings“ – die Suchmaschine sucht seither nicht mehr nach Zeichenketten, sondern nach den Objekten, die tatsächlich hinter einer Anfrage stehen. Laut Google umfasste der Knowledge Graph bereits 2020 rund 500 Milliarden Fakten zu etwa 5 Milliarden Entitäten. Im Kern werden Entitäten über zwei zentrale Elemente miteinander verknüpft: Attribute, also die Eigenschaften einer einzelnen Entität, und Relationen, also die Beziehungen zwischen mehreren Entitäten. Diese Verbindungen werden technisch in sogenannten Triples abgebildet, die aus Subjekt, Prädikat und Objekt bestehen und so ein riesiges, maschinenlesbares Netzwerk aus Fakten bilden.
Am Beispiel „Elvis Presley“ lässt sich dieses Prinzip gut nachvollziehen. Attribute wie Geburtsdatum, Beruf und Nationalität beschreiben die Entität selbst. Relationen wie „wohnte in Graceland“ oder „prägte Rock’n’Roll“ verknüpfen sie darüber hinaus mit weiteren Entitäten und Ereignissen. Der Knowledge Graph speist dabei längst nicht mehr nur die klassische Websuche: Auch Google Maps, die smarte Bilderkennung Google Lens und der KI-Assistent Gemini greifen auf dieselbe Datenbasis zurück, um Objekte, Orte und Zusammenhänge korrekt zu erkennen.
Ein verbreiteter Irrtum betrifft die Unterscheidung zwischen Knowledge-Panel-Einträgen und Featured Snippets. Beide erscheinen zwar häufig prominent in den Suchergebnissen, stammen aber aus völlig unterschiedlichen Quellen und verfolgen unterschiedliche Zielsetzungen:
| Merkmal | Knowledge Panel | Featured Snippet |
|---|---|---|
| Datenquelle | Google Knowledge Graph | Textausschnitt einer Website |
| Inhaltstyp | Fakten, Attribute und Relationen | Zusammenfassender Textabschnitt |
| Darstellung | Meist rechts in den Desktop-Suchergebnissen | Meist ganz oben über den organischen Treffern |
| Zielsetzung | Eindeutige Identifikation einer Entität | Schnelle Beantwortung einer konkreten Nutzerfrage |
| Beeinflussbar durch Content? | Nur indirekt, über vertrauenswürdige Datenquellen | Direkt durch gezielte Optimierung des Textes |
Attribute und Relationen einfach erklärt
Attribute beschreiben die inhärenten Eigenschaften einer einzelnen Entität – etwa die Adresse eines Unternehmens, den Preis eines Produkts oder das Gründungsjahr einer Marke. Relationen hingegen beschreiben die vielschichtigen Verbindungen zwischen mehreren Entitäten, beispielsweise „ist Teil von“, „arbeitet für“, „ist Sponsor von“ oder „befindet sich in“. Durch dieses strukturierte Zusammenspiel entsteht ein gigantisches Netzwerk aus Fakten, das es der Suchmaschine ermöglicht, auch komplexe thematische Zusammenhänge fehlerfrei zu interpretieren.
Am Beispiel der Entität „Puma“ (Unternehmen) wird der Unterschied besonders greifbar:
- Entität: Die Sportmarke „Puma“ fungiert als eindeutig identifizierbares Unternehmen.
- Attribut: Gründer – Rudolf Dassler; Gründungsjahr – 1948
- Relation: Hauptsitz befindet sich in Herzogenaurach
- Relation: ist Sponsor von Borussia Dortmund
- Relation: gehört zur Kategorie „Sportartikelhersteller“
Für die eigene Content-Strategie bedeutet das: Wer Attribute und Relationen einer Entität klar und explizit benennt, hilft Google, die Inhalte korrekt einzuordnen – unabhängig davon, wie oft ein einzelnes Keyword im Text vorkommt. Genau hier liegt der entscheidende Unterschied zwischen klassischer Keyword-Optimierung und moderner Entitäten SEO.
Von Hummingbird bis MUM – wie Google den Weg zur semantischen Suche ging
Der Weg zur semantischen Suche war kein einzelnes Update, sondern eine über ein Jahrzehnt andauernde, kontinuierliche Entwicklung. Mit Hummingbird startete Google 2013 den vielleicht größten Umbau seines Ranking-Systems – das Update betraf laut Google rund 90 Prozent aller Suchanfragen und brachte erstmals ein echtes Verständnis für die Zusammenhänge zwischen Wörtern statt reiner Zeichenketten. Zwei Jahre später folgte RankBrain, ein Machine-Learning-System, das Google vor allem hilft, bislang unbekannte Suchanfragen und ihre Intention besser zu deuten.
2019 verbesserte BERT die semantische Analyse von Suchanfragen erheblich, indem es Wörter im Kontext ganzer Sätze statt isoliert betrachtete und dabei auch den Bedeutungsgehalt von Präpositionen und Füllwörtern korrekt erfasste. Mit MUM folgte 2021/2022 ein weiterer Meilenstein: Laut Google ist das Modell rund 1.000-mal leistungsfähiger als BERT und kann Inhalte aus Text, Bild und Video gleichzeitig erfassen und thematisch vernetzen. Diese Entwicklung zeigt deutlich: Reine Keyword-Optimierung verliert seit über einem Jahrzehnt kontinuierlich an strategischer Bedeutung. Viele Website-Betreiber unterliegen dennoch dem Irrglauben, Keyword-Dichte sei weiterhin der zentrale Rankingfaktor. Tatsächlich zählt heute die thematische Abdeckung einer Entität deutlich mehr als die bloße Häufigkeit eines einzelnen Begriffs.
Die wichtigsten Updates im Überblick:
- Hummingbird (2013): Versteht Zusammenhänge zwischen Wörtern in Suchanfragen und legte das Fundament für kontextuelles Suchverständnis
- RankBrain (2015): Extrahiert Entitäten aus Suchanfragen mittels maschinellem Lernen, etwa Standortbezüge oder unbekannte Nutzerintentionen
- BERT (2019): Verbessert die semantische Analyse durch echtes Kontextverständnis ganzer Sätze
- MUM (2021/2022): Erkennt Inhalte über Text, Bild und Video hinweg und vernetzt komplexes Wissen multimodal

Wie Google Entitäten in Texten erkennt (NLP, NER, Salienz)
Damit Google Entitäten auch in unstrukturierten Texten zuverlässig erkennt, kommt Natural Language Processing (NLP) zum Einsatz. Dabei zerlegt Google Sätze systematisch in Subjekt, Prädikat und Objekt, um Attribute und Beziehungen zwischen Entitäten automatisch zu identifizieren – selbst wenn der Text keine expliziten technischen Markierungen enthält. Ein zentrales Verfahren dabei ist die Named Entity Recognition (NER). Sie erkennt Personen, Marken, Orte oder Produkte im Fließtext und ordnet sie potenziellen Entitäten im Knowledge Graph zu. Ergänzend löst die sogenannte Coreference Resolution unklare sprachliche Verweise wie „er“, „sie“ oder „das Unternehmen“ automatisch auf und verknüpft sie fehlerfrei mit der korrekten Entität im Text.
Ein Konzept, das dabei häufig unterschätzt wird, ist die Salienz. Sie beschreibt die tatsächliche Relevanz einer Entität im jeweiligen Textkontext – unabhängig davon, wie oft sie erwähnt wird. Die Salienz hängt vielmehr von mehreren Faktoren ab: ihrer Position im Text (Seitentitel, H1-Überschrift, erster Absatz), ihrer Satzstellung (Hauptsatz statt Nebensatz) und dem jeweiligen Entitätstyp. Genau hier liegt ein verbreitetes Missverständnis: Salienz ist kein Synonym für Keyword-Wiederholung, sondern für kontextuelle Prominenz und inhaltliche Wichtigkeit. Ein Begriff, der einmal prominent im ersten Absatz und in der Hauptaussage eines Satzes steht, kann eine höhere Salienz erreichen als ein Begriff, der zehnmal in Nebensätzen wiederholt wird.
Salienz-Optimierung in der Praxis:
– Zentrale Entität bereits im Seitentitel und in der H1-Überschrift nennen
– Wichtige Entitäten in Hauptsätzen statt Nebensätzen platzieren
– Zentrale Entität möglichst früh im Text erwähnen
– Beziehungen zwischen Entitäten explizit beschreiben
– Auf unnatürliches Keyword-Stuffing verzichten, da bloße Häufigkeit den Salience Score nicht erhöht
– Klare sprachliche Bezüge nutzen, um die Coreference Resolution für Google zu erleichtern
Praxisbeispiel: Google erkennt Zusammenhänge auch ohne exakte Textübereinstimmung
Ein anschauliches Beispiel zeigt, wie leistungsfähig entitätenbasierte Suche tatsächlich ist: Die englischsprachige Suchanfrage „brother of Freddie Mercury“ beantwortet Google korrekt mit dem Namen seiner Schwester – obwohl der berühmte Queen-Sänger nie einen Bruder hatte. Möglich wird das, weil die Entität „Bruder“ im Knowledge Graph eng mit der übergeordneten Entität „Geschwister“ verknüpft ist und das System diesen logischen Umweg selbstständig geht. Eine reine Keyword-Suche hätte hier entweder gar kein oder ein falsches Ergebnis geliefert, da der exakte Begriff „Bruder“ im Zusammenhang mit Freddie Mercury nirgends im Text korrekt vorkommt.
Für Content-Ersteller bedeutet dieses Beispiel sehr konkret: Inhalte sollten Zusammenhänge zwischen Entitäten explizit herstellen, statt lediglich isolierte Einzelbegriffe stur zu wiederholen. Wer Beziehungen wie „ist verwandt mit“, „arbeitet für“ oder „befindet sich in“ klar im Fließtext formuliert, erleichtert es Google erheblich, thematische Zusammenhänge korrekt zu erfassen und die eigenen Inhalte auch für komplexere, indirekte Suchanfragen relevant zu machen.
Merksatz: Google versteht Beziehungen zwischen Entitäten – nicht nur einzelne Wörter. Diese Erkenntnis sollte jede moderne Content-Strategie prägen.
E-E-A-T und Entitäten: Warum Vertrauen über Sichtbarkeit entscheidet
E-E-A-T steht für Experience, Expertise, Authority und Trustworthiness – Ende 2022 wurde das Konzept um den Faktor Experience als zweites E erweitert. Google bewertet damit, wie glaubwürdig eine Quelle in Bezug auf ein bestimmtes Thema tatsächlich ist. Der Zusammenhang zu Entitäten ist dabei direkter, als viele Website-Betreiber annehmen: Autoren, Unternehmen und Domains sind selbst Entitäten, die von Google kontinuierlich bewertet werden. Sind sie im Knowledge Graph mit nachweisbarer Fachautorität verknüpft, werden ihre Inhalte tendenziell als vertrauenswürdiger eingestuft. Ein Artikel über Herzkrankheiten wird beispielsweise deutlich höher bewertet, wenn der Autor ein Kardiologe mit belegbarer Publikationshistorie ist – im Vergleich zu einem anonymen Website-Betreiber ohne nachvollziehbare Quellen.
Besonders relevant ist dieser Zusammenhang für sogenannte YMYL-Branchen („Your Money, Your Life“) wie Gesundheit, Medizin und Finanzen. Hier unterliegen Inhalte besonders strengen Bewertungskriterien, da Fehlinformationen direkte Auswirkungen auf die Gesundheit oder finanzielle Entscheidungen der Nutzer haben können. Google möchte in diesen sensiblen Themenfeldern sicherstellen, dass ausschließlich glaubwürdige und fachlich fundierte Quellen prominent sichtbar werden. Für die praktische Umsetzung ergeben sich daraus konkrete Maßnahmen, mit denen sich die eigene Entität als Autor oder Unternehmen nachhaltig stärken lässt:
- Vollständige Autoren-Profile mit echten Qualifikationen, Publikationen und Kontaktmöglichkeiten anlegen
- Aussagekräftige Über-uns-Seiten mit nachvollziehbaren Fakten und Unternehmenshistorie pflegen
- Social-Media-Präsenzen konsistent mit Namen, Themenfeld und Fachexpertise verknüpfen
- Wikipedia- und Wikidata-Einträge für Personen und Unternehmen anstreben, sofern fachlich relevant und belegbar
Diese Maßnahmen wirken nicht isoliert, sondern verstärken sich gegenseitig: Je konsistenter eine Marke oder ein Autor über verschiedene Plattformen als eindeutige, fachlich kompetente Entität erkennbar ist, desto stärker fällt das Vertrauenssignal für Google aus. Gerade in Kombination mit strukturierten Daten und einer klaren thematischen Content-Struktur entsteht so ein belastbares Fundament für langfristige Sichtbarkeit.
Entitäten mit strukturierten Daten auszeichnen
Schema.org und das Format JSON-LD ermöglichen es, Entitäten maschinenlesbar zu kennzeichnen – und damit Googles Interpretation eines Inhalts deutlich zu erleichtern. Diese präzise technische Aufbereitung nimmt der Suchmaschine einen großen Teil der algorithmischen Arbeit ab, da sie sich nicht mehr ausschließlich auf das fehleranfällige Natural Language Processing verlassen muss, um die Kerninformationen einer Seite zu extrahieren. Ein praktisches Beispiel: Ein Hotel kann Adresse, Telefonnummer, Bewertungen und Sternebewertung als strukturierte Daten hinterlegen, wodurch Google es direkt als Entität vom Typ „Hotel“ einordnet, statt die Informationen mühsam aus Fließtext extrahieren zu müssen:
json

{

"@context": "https://schema.org",

"@type": "Hotel",

"name": "Grand Plaza Hotel",

"address": {

"@type": "PostalAddress",

"streetAddress": "Musterstraße 12",

"addressLocality": "Berlin",

"addressCountry": "DE"

},

"telephone": "+49-30-12345678",

"starRating": {

"@type": "Rating",

"ratingValue": "5"

}

}
Für das Verständnis lohnt sich eine Unterscheidung der drei Datenformen, mit denen Google grundsätzlich arbeitet:
- Strukturierte Daten: maschinenlesbar aufbereitet, etwa über JSON-LD, wodurch sie von Google sofort als Entität verstanden werden
- Semistrukturierte Daten: konsistent aufgebaut, aber nicht explizit maschinenlesbar – etwa Wikipedia-Artikel, deren Struktur klare inhaltliche Hinweise liefert
- Unstrukturierte Daten: reiner Fließtext, der nur über NLP-Verfahren mühsam verarbeitet werden kann
Schema.org kennt mittlerweile über 800 Entitätstypen, die Google mutmaßlich auch als Grundlage für die eigene interne Typisierung von Entitäten im Knowledge Graph nutzt. Ein häufiger Fehler in der Praxis: Strukturierte Daten werden oft nur eingesetzt, um optisch auffällige Rich Snippets in den Suchergebnissen zu erzielen. Ihr eigentlicher strategischer Wert liegt jedoch in der unmissverständlichen Kennzeichnung von Entitäten für die tiefe semantische Suche – ein Aspekt, der in vielen SEO-Strategien bislang deutlich unterschätzt wird.
Entitäten für die eigene SEO-Strategie recherchieren
Bevor ein Text geschrieben wird, sollten die für das Thema relevanten Entitäten systematisch identifiziert werden. Nur so lässt sich sicherstellen, dass ein Beitrag alle Aspekte abdeckt, die Google mit dem jeweiligen Thema in Verbindung bringt. Diese Recherche kostet zwar anfangs etwas mehr Zeit, verhindert aber, dass wichtige thematische Aspekte im späteren Text fehlen und bildet das unverzichtbare Fundament für Inhalte, die nicht nur kurzfristig ranken, sondern dauerhaft als semantische Autorität wahrgenommen werden.
Für die Recherche hat sich folgende Vorgehensweise in der Praxis bewährt:
- Google Knowledge Graph über die Knowledge-Graph-Suche auf technicalseo.com durchsuchen und den passenden Entitätstyp identifizieren
- Den zugehörigen Wikipedia-Artikel prüfen und dort verlinkte, thematisch relevante Entitäten notieren
- Den Wikidata-Eintrag öffnen, um Synonyme und die eindeutige ID der Entität zu finden
- Search-Console-Daten per N-Gram-Analyse auswerten, um zu verstehen, welche Begriffe und Zusammenhänge Nutzer tatsächlich erwarten
Praxisbeispiel: Bei einem Reiseblog zum Thema „Sehenswürdigkeiten in Rom“ sind unter anderem Orte wie Kolosseum, Vatikan und Pantheon relevant, Personen wie Michelangelo und Bernini, kulturelle Konzepte wie Renaissance und Barock sowie verwandte Begriffe wie Rom Pass oder beste Reisezeit. Werden diese Entitäten sinnvoll im Text verknüpft, erkennt Google den Beitrag als umfassende, ganzheitliche Quelle zum Thema.
Entitätsbasierten Content konkret strukturieren
Wie sich entitätsbasierter Content konkret von generischem Text unterscheidet, zeigt ein einfacher Vergleich: Statt „Das neue Modell hat viele Verbesserungen und ist sehr schnell“ liefert die Formulierung „Das iPhone 15 Pro bietet eine verbesserte Kamera mit 48-Megapixel-Sensor und A17-Chip“ deutlich mehr inhaltliche Substanz – und macht die Entität sowie ihre Attribute für Google klar erkennbar. Auch bei Überschriften lohnt sich Präzision: Eine entitätsbezogene H1 wie „Rom Sehenswürdigkeiten: Die wichtigsten Orte mit Geschichte“ liefert mehr semantischen Kontext als eine generische Formulierung wie „Top Sehenswürdigkeiten“.
Ebenso wichtig ist eine intelligente interne Verlinkung: Verwandte Entitäten im Text sollten konsequent auf thematisch passende Unterseiten verweisen, damit Google die logischen Zusammenhänge zwischen den Inhalten einer Website als zusammenhängendes Netzwerk nachvollziehen kann. Die Sprache selbst muss dabei klar und unmissverständlich formuliert sein, damit die Algorithmen die verknüpften Attribute zweifelsfrei der richtigen Entität zuordnen können.
Vorher/Nachher:
– ❌ „Das neue Modell hat viele Verbesserungen“ – zu generisch, keine klaren Entitäten erkennbar
– ✅ „Das iPhone 15 Pro bietet eine verbesserte Kamera mit 48-Megapixel-Sensor und A17-Chip“ – eindeutige Entität mit klaren Attributen
Brand Mentions, Google Business Profil und lokale Entitäten
Je häufiger eine Marke auf vertrauenswürdigen Websites erwähnt wird, desto stärker wird sie von Google als eigenständige Entität gewichtet – und das durchaus auch ohne einen klassischen Backlink. Bereits die reine Nennung im richtigen thematischen Kontext liefert ein wertvolles Signal für Relevanz und Autorität. Diese sogenannten Brand Mentions entstehen in der Praxis häufig auch auf indirektem Weg: Auch klassische Offline-Medien wie Print und TV tragen erheblich zu Brand Mentions bei, da entsprechende Themen im Anschluss häufig online in Foren und Kommentarspalten intensiv weiterdiskutiert werden.
Für lokale Unternehmen spielt zusätzlich das Google Business Profil eine zentrale Rolle als Herzstück der lokalen Entität. Ein vollständiger Eintrag mit aktuellen Öffnungszeiten, passenden Kategorien und authentischen Bewertungen stärkt die lokale Entität deutlich – etwa bei einem Friseursalon oder einer Arztpraxis. Ein weiterer relevanter Aspekt betrifft die rasant wachsende Sprachsuche: Da Voice-Search-Anfragen meist als vollständige, komplexe Fragen formuliert werden, ist die eindeutige Zuordnung von Entitäten entscheidend dafür, dass Google überhaupt eine korrekte, vorgelesene Antwort liefern kann.
Signale, die eine lokale oder Marken-Entität stärken:
- Vollständiges und aktuelles Google Business Profil mit korrekten Öffnungszeiten
- Konsistente Nennung von Name, Adresse und Kategorie über verschiedene Plattformen hinweg
- Erwähnungen auf themenrelevanten, vertrauenswürdigen Websites, auch ohne direkten Backlink
- Positive Bewertungen und aktive Interaktion mit Kundenfeedback
- Präzise Auswahl der passenden Unternehmenskategorien für eine treffsichere thematische Einordnung

Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen Keywords und Entitäten?
Keywords sind einzelne Wörter oder Phrasen einer Suchanfrage. Entitäten sind dagegen eindeutig identifizierbare Objekte oder Konzepte, die Google unabhängig von der sprachlichen Formulierung versteht. „Beste Pizza Berlin“ ist eine keywordbasierte Anfrage, „Pizzeria“ wäre die zugehörige Entität mit Attributen wie Standort und Öffnungszeiten.
Welche Rolle spielt der Google Knowledge Graph für SEO?
Er ist die zentrale semantische Datenbank, in der Entitäten mit ihren Attributen und Relationen gespeichert sind – laut Google bereits 2020 mit rund 5 Milliarden Entitäten und 500 Milliarden Fakten. Inhalte, die klar auf im Graphen erfasste Entitäten einzahlen, haben höhere Chancen auf eine Darstellung im Knowledge Panel.
Wie erkennt Google Entitäten in unstrukturierten Texten?
Über Natural Language Processing, Named Entity Recognition und die Analyse von Triples aus Subjekt, Prädikat und Objekt. Der Salience Score bewertet zusätzlich, wie wichtig eine Entität im jeweiligen Textkontext ist.
Welche Bedeutung hat E-E-A-T für entitätsbasiertes SEO?
Autoren und Unternehmen sind selbst Entitäten. Ihre nachweisbare Erfahrung, Expertise, Autorität und Vertrauenswürdigkeit beeinflussen, wie stark ihre Inhalte im Zusammenhang mit anderen Entitäten gewichtet werden – besonders relevant in YMYL-Branchen wie Gesundheit und Finanzen.
Wie recherchiert man relevante Entitäten für einen Text?
Über die Knowledge-Graph-Suche etwa auf technicalseo.com, Wikipedia-Verlinkungen, Wikidata-Einträge und eine N-Gram-Analyse der eigenen Search-Console-Daten.
Merksatz: Entitäten ersetzen Keywords nicht, aber sie erfordern ein Denken in echten Themenkomplexen statt in isolierten Suchbegriffen.
Wie können wir helfen?
Wo drückt der Schuh? Wo klemmt’s?
-
-
- Läuft die Technik nicht rund?
- Habt Ihr noch kein echtes Branding?
- Wollt Ihr mehr Werbung machen aber wisst nicht wo Ihr anfangen sollt?
- Sollen Mitarbeiter Marketingfelder übernehmen – sind aber nicht dafür ausgebildet?
- Braucht Ihr einen Sparringspartner für strategische Marketing Fragen?
- Wollt Ihr Wissen wo im Fluss die Steine liegen um drüberzulaufen?
Klingt nach deiner Situation? Lass uns reden! Buche jetzt einen Call mit unserem Team und wir zeigen in 45 Minuten, wie wir Dir in deinem Fall helfen können.
-
Fazit
Entitäten sind heute ein zentraler Bestandteil moderner Suchmaschinenoptimierung – und für viele Themen bereits deutlich wichtiger als reine Keyword-Dichte. Wer Inhalte klar auf Entitäten, ihre Attribute und Relationen ausrichtet, verbessert die Chancen auf bessere Rankings, Knowledge-Panel-Sichtbarkeit und Relevanz in KI-gestützten Suchsystemen erheblich. Eine fundierte Entitäten SEO-Strategie lässt sich allerdings nicht nebenbei umsetzen. Sie erfordert sorgfältige Recherche, technisches Verständnis für strukturierte Daten und eine klare Content-Struktur, die Zusammenhänge zwischen Themen sichtbar macht – von der Salienz-Optimierung im Fließtext über strukturierte Daten bis hin zum konsequenten Aufbau von E-E-A-T-Signalen und lokalen Entitäten.
Du willst wissen, wie deine Website und deine Marke als Entität bei Google und in KI-Suchsystemen wahrgenommen werden? Lass uns das gemeinsam analysieren – Analyse anfragen.
Wir sind hier
Büro Zeiten: 09:00 – 17:00 Uhr
Lützowstraße 102-104, 10785 Berlin+49 30 914 78 075info[at]wir-branden.de